На Hugging Face виклали «нецензуровану» GLM-5.3 на 753 млрд параметрів – навіть квантовану версію тестували на восьми A100
 ·
02.10.2026 20:55
·
3 хвилини читання
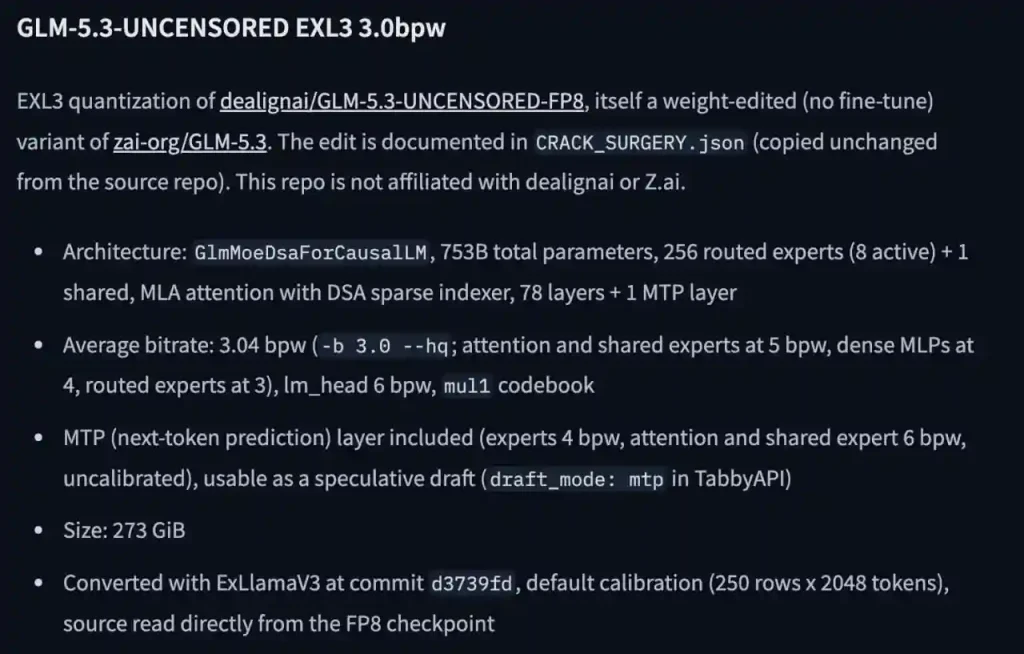
На Hugging Face з’явилася неофіційна «нецензурована» версія GLM-5.3 від Z.ai, у якій автори спробували суттєво зменшити кількість відмов на чутливі запити. Модель містить 753 млрд параметрів, а навіть її сильно стиснута версія займає близько 273 ГіБ, тож для звичайного домашнього комп’ютера вона практично недоступна.
Йдеться про GLM-5.3-UNCENSORED-EXL3-3.0bpw, яку створив користувач Infatoshi. Це сторонній проєкт, не пов’язаний із Z.ai.
Основою стала офіційна GLM-5.3 – Mixture-of-Experts-модель із 753 млрд параметрів, 256 маршрутизованими експертами та вісьмома активними експертами на токен. Z.ai орієнтує її насамперед на програмування, тривалі агентні задачі та кібербезпеку.
Обмеження змінювали прямо у вагах моделі
«Uncensored»-версія з’явилася без традиційного додаткового навчання.
Спочатку автор іншого проєкту, dealignai, відредагував FP8-ваги GLM-5.3, щоб змінити поведінку моделі та зменшити ймовірність відмов. Потім Infatoshi додатково квантував цю версію у формат EXL3 приблизно до 3,04 біта на вагу.
Тож слово «uncensored» тут варто сприймати як назву та заявлену мету модифікації, а не як гарантію повної відсутності обмежень. Поведінка моделі після редагування ваг і агресивного квантування може відрізнятися від вихідної GLM-5.3.
Сам автор провів невелике порівняння з оригінальною FP8-версією. На двох агентних тестах квантована модель показала дещо нижчі результати, однак за використаного розміру вибірки різниця не досягла статистичної значущості.
273 ГіБ – і це вже сильно стиснута версія
Головна проблема для локального запуску – розміри.
EXL3-квантування займає близько 273 ГіБ. Автор тестував його через TabbyAPI на системі з вісьмома NVIDIA A100 по 40 ГБ, тобто із сумарними 320 ГБ відеопам’яті.
Це добре показує масштаб моделі: навіть після зниження точності приблизно до трьох бітів вона залишається далеко за межами можливостей звичайної ігрової відеокарти та більшості робочих станцій.
Повноцінна FP8-версія потребує ще значно більше пам’яті. Теоретично частину моделі можна вивантажувати в оперативну пам’ять або використовувати інші схеми розподіленого запуску, але це серйозно ускладнює конфігурацію і зазвичай знижує швидкість генерації.
FOUND A MASSIVE UNCENSORED GLM-5.3 MODEL 👀
— Forha (@Forhanvv) October 2, 2026
GLM-5.3 UNCENSORED is available in EXL3 3.0bpw for local inference.
• based on GLM-5.3
• uncensored / refusal-reduced
• EXL3 3.0bpw quantization
• 146B parameters listed on Hugging Face
• built for local inference
• compatible… https://t.co/8d3Q2LpvQo pic.twitter.com/4VfmzBdL8A
Водночас ваги можна завантажити безкоштовно. Репозиторій конкретної EXL3-модифікації позначено ліцензією MIT, однак безкоштовні ваги не означають безкоштовної експлуатації – для комфортного запуску знадобиться дороге серверне обладнання або оренда кількох GPU.
На момент публікації ця версія також не під’єднана до жодного вбудованого inference-провайдера Hugging Face, тож запустити її безпосередньо зі сторінки моделі однією кнопкою не можна.
Вийшла досить показова ілюстрація сучасного open-weight ШІ: модель справді можна завантажити й розгорнути самостійно, але її 753 млрд параметрів перетворюють «локальний запуск» радше на задачу для GPU-сервера, ніж для домашнього ПК.