Google выпустила модель Nano Banana 2.1: генерация картинок в 4K и точное сохранение лиц при редактировании
 ·
06.10.2026 21:51
·
2 минуты чтения
6 октября 2026 года Google представила генеративную модель Nano Banana 2.1, предназначенную для создания и точечного редактирования изображений. Разработка базируется на архитектуре Gemini 3.6 Flash и решает одну из главных проблем графических нейросетей — «галлюцинации» при внесении мелких правок. Новая версия умеет точечно менять отдельные детали кадра, не искажая черты лица персонажей, ключевые объекты и общее освещение. Модель уже перешла в статус общедоступного релиза (GA) и доступна через Google AI Studio и Gemini API.
В отличие от многих диффузионных систем, которые при малейшем изменении промпта перерисовывают сцену с нуля, Nano Banana 2.1 ориентирована на сохранение контекста. Если попросить нейросеть заменить одежду на человеке или переставить предмет на столе, она не изменит анатомию героя и геометрию комнаты. В карточке модели от Google DeepMind отмечается, что в тестах на консистентность персонажей и перенос стилей новинка превзошла не только прошлую версию Nano Banana 2, но и более тяжелую Nano Banana Pro.
До 14 референсов и разрешение 4K
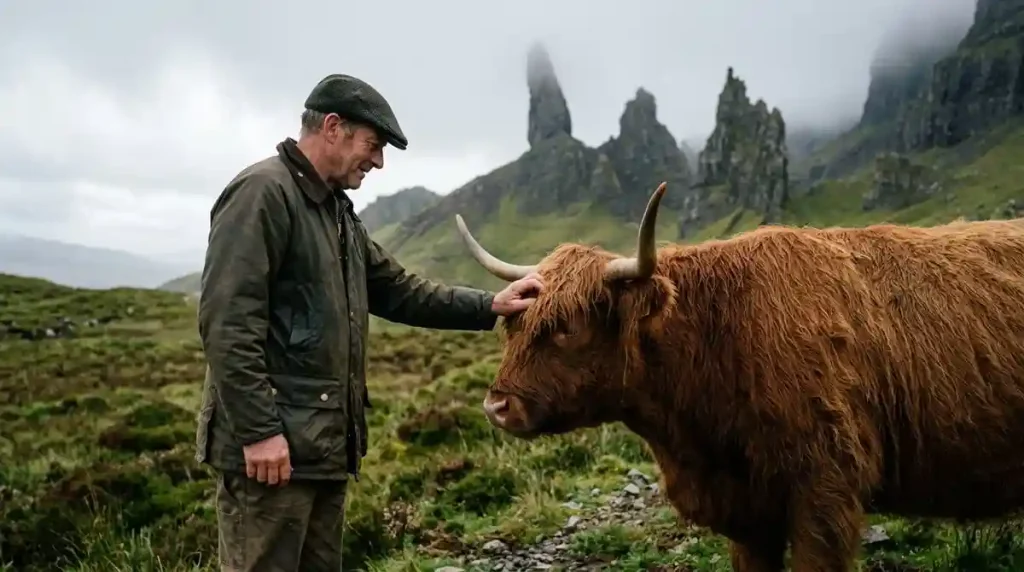
Модель получила значительный апгрейд технических возможностей для коммерческого дизайна и создания контента:
- Мультиреференсный режим: в один запрос можно передавать до 14 исходных изображений, при этом нейросеть стабильно удерживает внешность до четырех персонажей и свойства до десяти отдельных предметов;
- Форматы вывода: поддерживается генерация в нативных разрешениях 1K, 2K и 4K;
- Панорамные пропорции: разработчики устранили краевые искажения при создании ультрашироких изображений с соотношением сторон до 8:1;
- Типографика: улучшен рендеринг сложного текста внутри кадра, надписей на этикетках и элементов инфографики.
Как сообщается в документации Google AI for Developers, алгоритм можно напрямую связывать с Google Search и поиском по картинкам, чтобы модель учитывала свежую визуальную информацию из сети.
Уровни размышлений и доступ для разработчиков
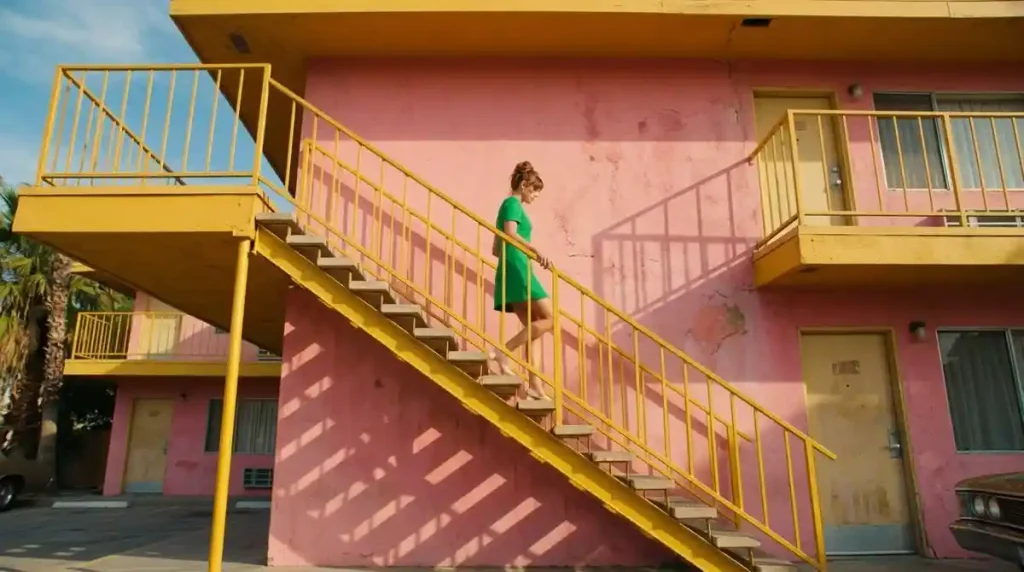
Для сложных творческих задач в модель добавили регулировку глубины рассуждений (reasoning). Разработчикам доступны три режима — minimal, medium и high. При выборе максимального уровня нейросеть тратит больше времени на пошаговое планирование композиции перед генерацией пикселей, что снижает процент брака при сложных манипуляциях со светом и перспективой.
Модель распространяется под идентификатором gemini-nano-banana-2.1 на платформе Google Cloud и в API. Оценить работу алгоритма в веб-интерфейсе можно напрямую через песочницу Google AI Studio, протестировав генерацию в режиме реального времени.