ШІ-аватар для відеодзвінків обдурив половину співрозмовників: як працює нова модель Griffin-Lite від Tavus
 ·
02.10.2026 23:54
·
3 хвилини читання
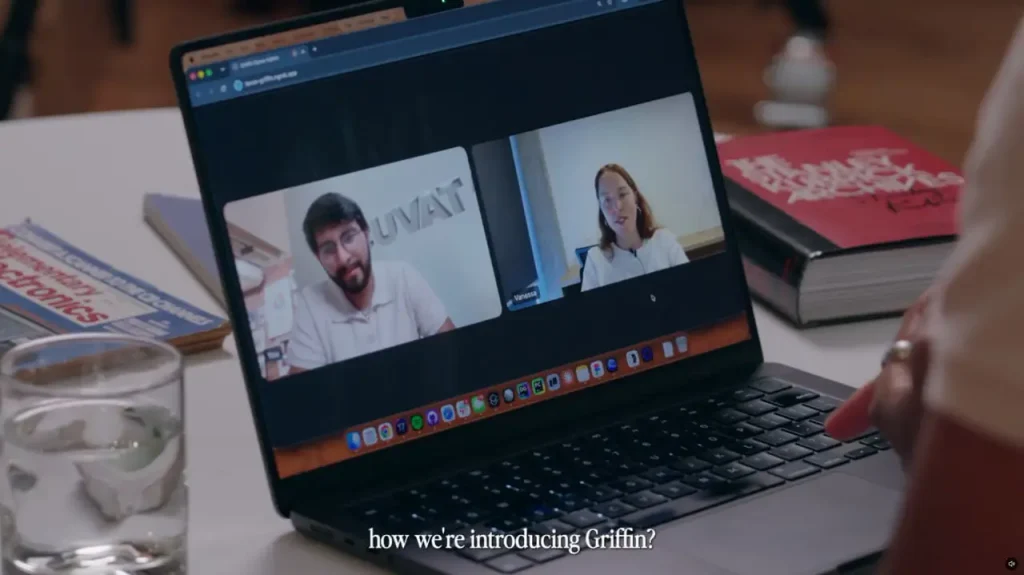
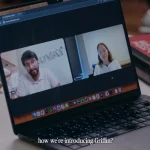
У жовтні 2026 року стартап Tavus представив генеративну модель Griffin-Lite, призначену для відеодзвінків у реальному часі. Під час внутрішніх випробувань системи 48% учасників експерименту не зрозуміли, що спілкуються зі штучним інтелектом, і сприйняли нейромережу за живу людину. Для індустрії цифрових аватарів це серйозний стрибок у реалістичності, проте гучні заголовки про «проходження відеотесту Тюринга» поки що варто сприймати зі здоровим скепсисом.
В дослідженні Tavus взяли участь 54 людини. Їм повідомили, що сервіс з’єднає їх із випадковим співрозмовником для короткого дзвінка, щоб обговорити очікування від поточного року. Насправді ж на іншому кінці екрана був згенерований аватар. Лише після розмови організатори запитували, чи не здався співрозмовник штучним. 26 осіб відповіли заперечно, причому їхня середня впевненість у тому, що вони говорили з живою людиною, становила 79%.
Прогрес розробників стає очевидним при порівнянні з попередніми поколіннями. Аналогічний тест попередньої збірки Tavus на базі Phoenix-4.5 і Sparrow-2 зміг обдурити лише одного учасника з 41 (2,4%). Однак умови нинішнього успіху були штучно звужені: розмова тривала лише одну хвилину і не передбачала несподіваних тем. Тож 48% — це показник якості конкретної короткої симуляції, а не доказ повної невідрізненності моделі від людини у вільному тривалому діалозі.
Кінець незручним паузам: як працює Full-Duplex
Головною технологічною відмінністю Griffin-Lite від більшості наявних візуальних чат-ботів став режим full-duplex. Зазвичай ШІ-аватари працюють за принципом рації: чекають, поки користувач завершить аудіозапит, беруть паузу на обробку і видають відповідь монологом.
Модель Tavus бачить і чує користувача безперервно, навіть коли говорить сама. Аватар уміє зчитувати міміку, кивати в такт чужій мові, вставляти короткі підтверджувальні репліки й миттєво замовкати, якщо співрозмовник вирішив його перебити. Саме ця здатність підтримувати природний ритм людської бесіди без мікрозатримок і створює ілюзію спілкування з реальним оператором.
Introducing Griffin, the first model to pass the video Turing test.
— Tavus (@tavus) October 1, 2026
48% of people who talked to it live thought it was a real human. Previous systems have had a pass rate <3%. It is #1 on NVIDIA's benchmark for full-duplex AI video.
It’s the first Human Interaction Model (HIM). pic.twitter.com/eb11XbC8Xr
Незалежний тест NVIDIA і ризики обману
Високу якість генерації підтверджують не лише корпоративні опитування, а й сторонні бенчмарки. У тестуванні VideoFDB від NVIDIA, яке оцінює повноцінну аудіовізуальну взаємодію, Griffin-Lite набрав 3,83 бала з 5 можливих за якість генерації (результат живої людини-еталона становив 3,92). Для порівняння, зв’язка з Gemini 2.5 і Anam отримала в цьому ж тесті лише 2,80 бала.
У Tavus чудово розуміють ризики, пов’язані з технологією такого рівня. Керівництво стартапу відмовилося випускати Griffin-Lite у публічний доступ, побоюючись використання реалістичних аватарів для шахрайства. Нині інженери працюють над механізмами, які примусово повідомлятимуть співрозмовникам, що перед ними нейромережа. До того часу доступ до моделі відкритий лише вузькому колу довірених тестувальників у форматі дослідницького прев’ю.