Brain-IT відтворює побачені людиною зображення за fMRI — для адаптації до нової людини достатньо години даних
 ·
03.10.2026 15:49
·
3 хвилини читання
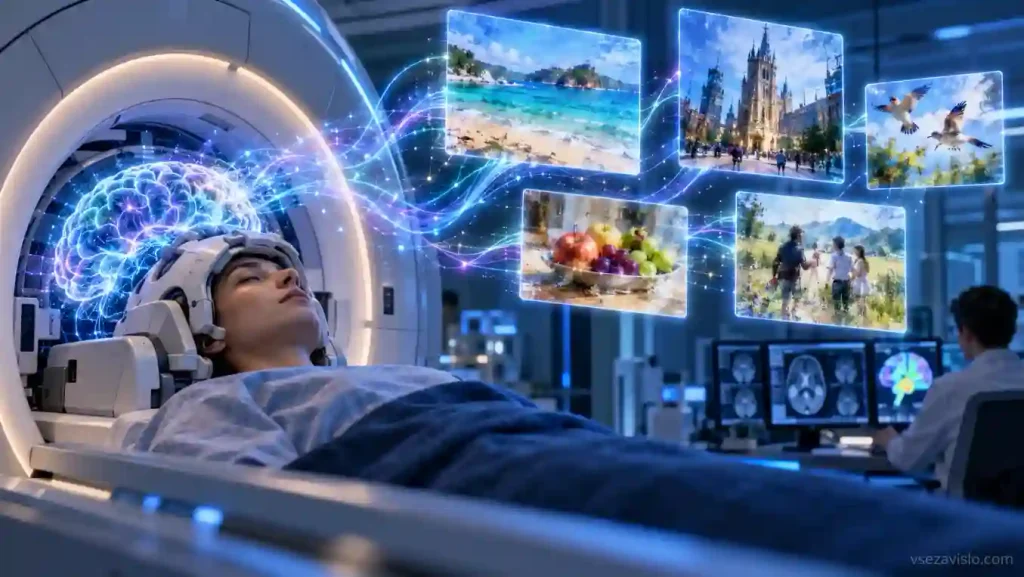
Дослідники з Інституту Вейцмана розробили Brain-IT — систему, яка реконструює зображення за активністю мозку людини під час їх перегляду. Модель аналізує дані функціональної МРТ і за допомогою генеративного ШІ намагається відтворити зміст сцени, розташування об’єктів і частину візуальних деталей. Роботу прийнято на ICLR 2026, а вихідний код дослідники опублікували на GitHub.
Попри формулювання про «читання думок», Brain-IT поки що виконує значно вужче завдання. Людина лежить у fMRI-сканері й дивиться на конкретну картинку, а алгоритм отримує зафіксовану в цей момент активність мозку й намагається відтворити побачене. Система не декодує внутрішнє мовлення, спогади чи довільні думки.
Одна година замість десятків годин сканування
Одна з головних проблем таких технологій — необхідність навчати модель окремо для кожної людини. Мозок різних людей влаштований трохи по-різному, а збір fMRI-даних займає багато часу й потребує дорогого обладнання.
У Brain-IT дослідники об’єднують у функціональні кластери воксели — невеликі об’ємні елементи fMRI-даних, — які виконують схожі завдання в різних учасників. Як пояснюють автори проєкту, модель працює одразу з двома типами ознак. Семантичні допомагають визначити, що саме зображено, наприклад обличчя чи їжа, а низькорівневі відповідають за загальну структуру та розташування об’єктів.
Такий підхід дає змогу використовувати знання, отримані на даних інших людей. Для нового учасника приблизно однієї години індивідуальних fMRI-записів виявилося достатньо, щоб наблизитися до якості попередніх методів, які навчалися приблизно на 40 годинах даних. У тестах на Natural Scenes Dataset Brain-IT перевершила порівнювані підходи за сімома з восьми використаних метрик.
До того ж година — не абсолютний мінімум: на сторінці проєкту дослідники показують осмислені реконструкції навіть після 15 хвилин даних. Однак саме результат з однією годиною вони використовують для прямого порівняння з методами, яким потрібен був повний набір записів.
Це реконструкція, а не фотографія з мозку
Отримані зображення не є точними копіями побаченого. Brain-IT може правильно відтворити тип сцени, основні об’єкти та їхнє розташування, але змінити колір, форму чи конкретні деталі. Причина в самій архітектурі: система вилучає з fMRI візуальні ознаки, після чого дифузійна модель генерує відповідне зображення, а не зчитує з мозку готовий кадр.
Це обмеження принципове для розуміння технології. За нинішніми результатами Brain-IT радше показує, скільки інформації про зорове сприйняття можна витягти з активності мозку, ніж наближає універсальний «сканер думок».
Інститут Вейцмана вже називає наступними напрямами декодування звуків і в перспективі відео. Останнє помітно складніше через низьку часову роздільну здатність fMRI: один замір триває близько двох секунд, тоді як відеоряд змінюється багато разів за секунду. Тож відтворення снів поки що залишається можливим майбутнім напрямом досліджень, а не функцією наявної Brain-IT.