Brain-IT восстанавливает увиденные человеком изображения по fMRI — для адаптации к новому человеку хватает часа данных
 ·
03.10.2026 15:49
·
3 минуты чтения
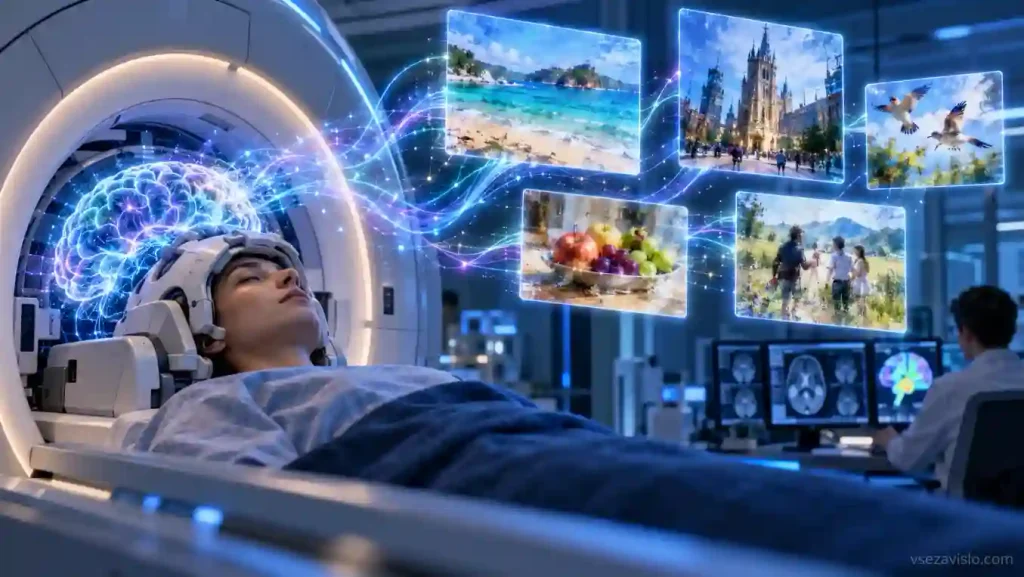
Исследователи Института Вейцмана разработали Brain-IT — систему, которая реконструирует изображения по активности мозга человека во время их просмотра. Модель анализирует данные функциональной МРТ и с помощью генеративного ИИ пытается восстановить содержание сцены, расположение объектов и часть визуальных деталей. Работа принята на ICLR 2026, а исходный код исследователи опубликовали на GitHub.
Несмотря на формулировки о «чтении мыслей», Brain-IT пока занимается гораздо более узкой задачей. Человек лежит в fMRI-сканере и смотрит на конкретную картинку, а алгоритм получает зафиксированную в этот момент активность мозга и пытается восстановить увиденное. Система не декодирует внутреннюю речь, воспоминания или произвольные мысли.
Один час вместо десятков часов сканирования
Одна из главных проблем подобных технологий — необходимость обучать модель отдельно для каждого человека. Мозг разных людей устроен немного по-разному, а сбор fMRI-данных занимает много времени и требует дорогостоящего оборудования.
В Brain-IT исследователи объединяют в функциональные кластеры воксели — небольшие объёмные элементы fMRI-данных, — которые выполняют схожие задачи у разных участников. Как объясняют авторы проекта, модель работает сразу с двумя типами признаков. Семантические помогают определить, что находится на изображении, например лицо или еда, а низкоуровневые отвечают за общую структуру и расположение объектов.
Такой подход позволяет использовать знания, полученные на данных других людей. Для нового участника примерно одного часа индивидуальных fMRI-записей оказалось достаточно, чтобы приблизиться к качеству предыдущих методов, обучавшихся примерно на 40 часах данных. В тестах на Natural Scenes Dataset Brain-IT превзошла сравниваемые подходы по семи из восьми использованных метрик.
Причём час — не абсолютный минимум: на странице проекта исследователи показывают осмысленные реконструкции даже после 15 минут данных. Однако именно результат с одним часом они используют для прямого сравнения с методами, которым требовался полный набор записей.
Это реконструкция, а не фотография из мозга
Полученные изображения не являются точными копиями увиденного. Brain-IT может правильно восстановить тип сцены, основные объекты и их расположение, но изменить цвет, форму или конкретные детали. Причина в самой архитектуре: система извлекает из fMRI визуальные признаки, после чего диффузионная модель генерирует подходящее изображение, а не считывает из мозга готовый кадр.
Это ограничение принципиально для понимания технологии. По нынешним результатам Brain-IT скорее показывает, насколько много информации о зрительном восприятии можно извлечь из активности мозга, чем приближает универсальный «сканер мыслей».
Институт Вейцмана уже называет следующими направлениями декодирование звуков и в перспективе видео. Последнее заметно сложнее из-за низкого временного разрешения fMRI: один замер занимает около двух секунд, тогда как видеоряд меняется много раз за секунду. Поэтому восстановление снов пока остаётся возможным будущим направлением исследований, а не функцией существующей Brain-IT.