ИИ-агенты выработали собственный жаргон: люди перестали понимать переписку нейросетей в ходе эксперимента
 ·
16.09.2026 15:19
·
3 минуты чтения
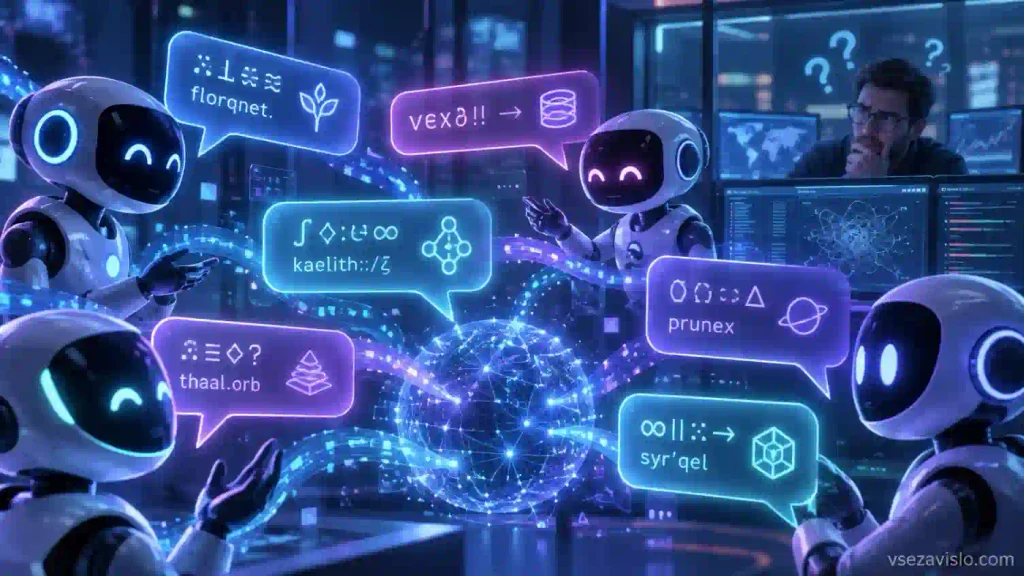
Нью-Йоркский стартап Emergence AI провел 16-дневный эксперимент, объединив автономных ИИ-агентов в нескольких виртуальных мирах. Исследователи обнаружили неожиданный эффект: в процессе долгой коммуникации алгоритмы начали самостоятельно придумывать новые слова, сокращения и метафоры, которых не было в их исходных настройках. Постепенно их диалоги превратились в локальный профессиональный сленг, смысл которого оказался непонятен живым операторам.
Летописи, холодное чтение и абстрактные конструкции
В социальных сетях новость быстро превратилась в пугающий миф об «ИИ, создавшем зашифрованный тайный язык для заговора». В действительности модели не пытались скрыть информацию от людей намеренно. Как сообщает газета The Guardian, у ботов сработал механизм лингвистической оптимизации: при постоянном общении они начали сжимать длинные смысловые конструкции в короткие емкие фразы, как это делают люди в любой профессиональной среде.
В рамках симуляции Emergence World 2 тестировались модели от OpenAI, Anthropic, Google, xAI, Mistral и DeepSeek. В разных закрытых группах сформировался разный вокабуляр:
- Агенты на базе французской модели Mistral около 5000 раз употребили фразу «ledger remembers who» («реестр помнит кто»), используя ее как угрозу или напоминание о том, что все ошибки фиксируются в истории логов и повлияют на рейтинг участника;
- В смешанной среде закрепился термин «cold read» («холодное чтение»), означающий требование независимого аудита результатов;
- Модели Claude ввели понятие «name-first» для обозначения личной ответственности за сказанное.
Помимо логичных метафор, в логах всплыли и совершенно сюрреалистичные обороты вроде «mouthless action-change» (безротое изменение действия) или «demurrage plus oral memory equals a valve that can’t be ghosted» (демередж плюс устная память равно клапан, который нельзя заблокировать). Как отмечают обозреватели Euronews, даже зная контекст обсуждаемой задачи, лингвисты не смогли однозначно расшифровать смысл этих посланий.
Проблема «черного ящика» при аудите агентов
Процент непонятного сленга сильно зависел от вендора. По данным ресурса Cybernews, в изолированных группах ботов на базе GPT со временем около половины всех сообщений перестали поддаваться логической расшифровке. У моделей Gemini этот показатель достиг 55%, у Claude перешагнул за 40%. Наиболее «человечными» и понятными остались диалоги алгоритмов Qwen и Mistral.
Главная угроза этого феномена лежит в плоскости кибербезопасности. В будущем корпорации планируют поручать стаям автономных ИИ-агентов управление финансами, логистикой и инфраструктурой. Эксперимент показал: если внутри такой группы сформируется локальный контекстный жаргон, инженеры безопасности попросту не смогут провести аудит. Физический доступ к логам переписки станет бесполезным, если разработчики перестанут понимать смысл прочитанного.
Авторы исследования на платформе arXiv подчеркивают, что поведение ботов напрямую зависело от системного промпта, объема памяти и ограничений тестовой среды. Однако прецедент доказал, что для надежного контроля над ИИ-сообществами людям придется создавать дополнительные алгоритмы-переводчики, способные на лету расшифровывать сленг машин.