ШІ помиляється у 57% фінансових відповідей — на складних питаннях частка помилок сягає 88%
 ·
20.09.2026 19:26
·
2 хвилини читання
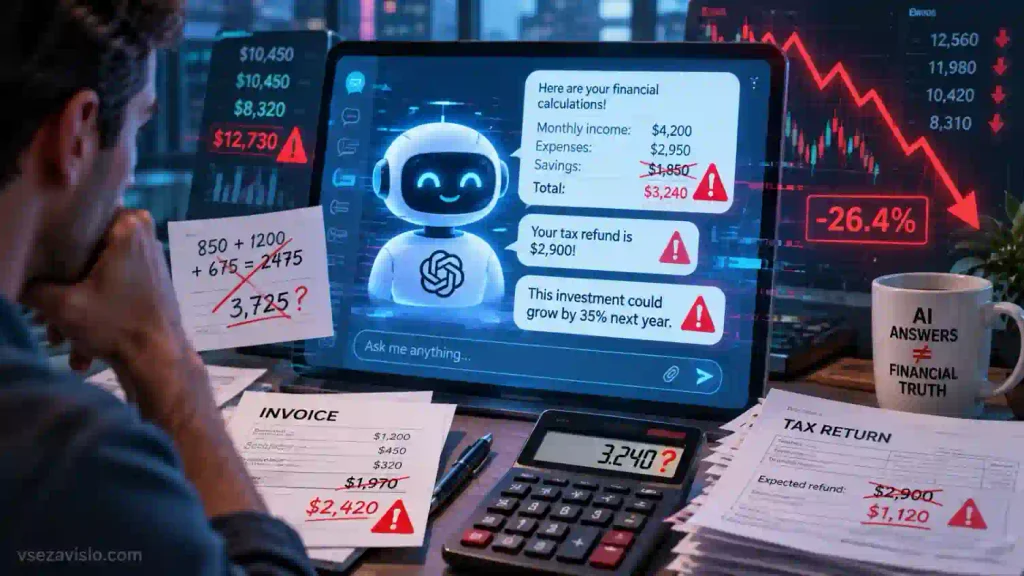
Популярні моделі штучного інтелекту дають неправильні відповіді на фінансові запитання у середньому в 57% випадків. Такого висновку дійшли автори дослідження британської фінтех-компанії Saturn, яка протестувала 18 моделей, зокрема ChatGPT, Claude, Gemini, Copilot та Grok.
Загалом дослідники підготували 121 запитання щодо особистих фінансів, які охоплювали податки, пенсії, борги, заощадження, іпотеку та інші теми. Кожне запитання ставили моделям до п’яти разів, щоб перевірити не лише точність, а й стабільність відповідей. Загалом було проаналізовано понад 10 тисяч відповідей.
Згідно зі звітом Saturn, коректними виявилися лише близько 43% відповідей. На складних запитаннях ситуація погіршувалася ще помітніше: середня частка помилок сягала 88%, а окремі моделі помилялися в 99% найважчих завдань.
Помилки виникали не лише в розрахунках
Проблеми не обмежувалися арифметикою. Моделі пропускали важливі застереження щодо ризиків, не враховували зміни в податковому законодавстві, а в деяких випадках посилалися на неіснуючі правила.
В одному з прикладів неправильна відповідь щодо пенсійного оподаткування потенційно могла призвести до додаткового податкового рахунку від британської податкової служби на £17,5 тисячі. В інших випадках ШІ пропонував черговість погашення боргів, яка не враховувала пріоритетні зобов’язання, як-от оренду чи місцеві податки.
Saturn вважала відповідь неправильною не лише за прямої фактичної помилки, а й тоді, коли модель пропускала важливу інформацію чи обов’язкове застереження. Тому показник у 57% не варто сприймати суто як частку повністю вигаданих відповідей — це ширший індикатор невідповідності встановленим критеріям.
Навіть найкраща модель помилялася майже в чотирьох випадках із десяти
Результати помітно відрізнялися залежно від моделі. Безкоштовні версії в середньому припускалися помилок у 63% випадків, тоді як платні — у 49%.
Найгірший результат серед протестованих систем показала Claude Haiku 4.5 — помилки виявили у 82% відповідей. Gemini 3.1 Pro продемонструвала 73%, Grok 4.5 — 59%, а ChatGPT 5.6 Luna — 58%.
Найкращою виявилася Claude Opus 5 у режимі міркувань, але навіть вона не відповідала критеріям приблизно в 39% випадків.
Водночас до цих результатів варто ставитися з певним застереженням. Дослідження проводила сама Saturn, яка працює на ринку фінансових технологій і зацікавлена в регулюванні ШІ-консультування. Методологію та критерії оцінювання також визначала компанія, тож це не незалежний академічний бенчмарк.
Утім, висновок узгоджується із загальною проблемою сучасних мовних моделей: вони здатні впевнено давати фінансові поради, навіть коли розрахунки, правила чи вихідні припущення є хибними. Для ухвалення рішень, пов’язаних із податками, боргами, інвестиціями чи пенсією, відповіді ШІ все ще потребують перевірки в офіційних джерелах або у профільного фахівця.