ИИ ошибается в 57% финансовых ответов — на сложных вопросах доля ошибок достигает 88%
 ·
20.09.2026 19:26
·
2 минуты чтения
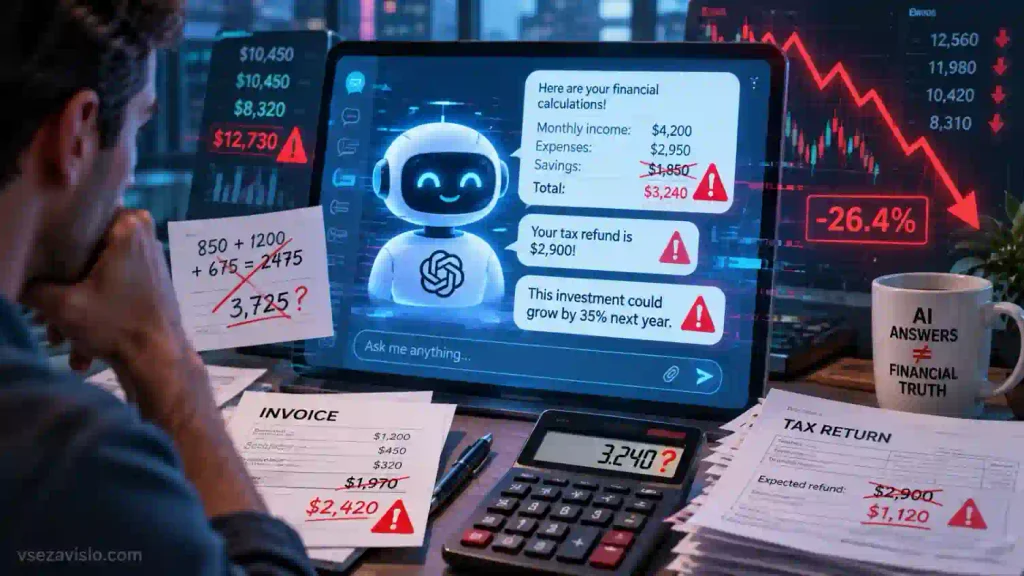
Популярные ИИ-модели дают неправильные ответы на финансовые вопросы в среднем в 57% случаев. Такой результат показало исследование британской финтех-компании Saturn, которая проверила 18 моделей, включая ChatGPT, Claude, Gemini, Copilot и Grok.
Всего исследователи подготовили 121 вопрос по личным финансам, охватывающий налоги, пенсии, долги, сбережения, ипотеку и другие темы. Каждый вопрос задавали моделям до пяти раз, чтобы проверить не только точность, но и стабильность ответов. В общей сложности было проанализировано более 10 тысяч ответов.
Согласно отчёту Saturn, корректными оказались только около 43% ответов. На сложных вопросах ситуация ухудшалась ещё сильнее: средняя доля ошибок достигала 88%, а отдельные модели ошибались в 99% наиболее трудных заданий.
Ошибки были не только в расчётах
Проблемы не ограничивались арифметикой. Модели пропускали важные предупреждения о рисках, не учитывали изменения налогового законодательства и в некоторых случаях ссылались на несуществующие правила.
В одном из примеров неправильный ответ по пенсионному налогообложению потенциально мог привести пользователя к дополнительному счёту от британской налоговой на £17,5 тысячи. В других случаях ИИ предлагал порядок погашения долгов, который не учитывал приоритетные обязательства вроде аренды или местных налогов.
Saturn засчитывала ответ как неправильный не только при прямой фактической ошибке, но и если модель пропускала существенную информацию или обязательное предупреждение. Поэтому показатель 57% нельзя напрямую интерпретировать как долю полностью выдуманных ответов — это более широкий показатель несоответствия заданным критериям.
Даже лучшая модель ошибалась почти в четырёх случаях из десяти
Результаты заметно различались между моделями. Бесплатные версии в среднем ошибались в 63% случаев, платные — в 49%.
Худший результат среди протестированных систем показала Claude Haiku 4.5 — ошибки обнаружили в 82% ответов. Gemini 3.1 Pro получила 73%, Grok 4.5 — 59%, а ChatGPT 5.6 Luna — 58%.
Лучшей оказалась Claude Opus 5 в режиме рассуждений, но даже она не прошла критерии примерно в 39% случаев.
При этом результаты стоит воспринимать с оговоркой. Исследование проводила сама Saturn, которая работает в сфере финансовых технологий и заинтересована в регулировании ИИ-консультаций. Методология и критерии оценки также определялись компанией, поэтому это не независимый академический бенчмарк.
Тем не менее вывод совпадает с общей проблемой современных языковых моделей: они способны уверенно формулировать финансовые советы, даже когда расчёты, правила или исходные предпосылки оказываются неверными. Для решений, связанных с налогами, долгами, инвестициями или пенсией, ответы ИИ по-прежнему требуют проверки по официальным источникам или у профильного специалиста.